
메인엔진 한 기종에 태그가 250개 붙어 있습니다.
태그마다 정격 전압, 주파수, 상 수, 무게 같은 속성을 채워야 하고, 그 값은 1,500쪽 가까운 도면과 사양서 어딘가에 있습니다. 대부분 스캔본이라 검색도 안 됩니다.
설계팀 여러 명이 붙어도 1~2주가 걸립니다. 다음 호선에서 같은 일을 또 합니다.
도면 AI를 알아보는 분들이 가장 먼저 묻는 것도 이 일입니다. "도면을 넣으면 값이 나오나요?"
저희 팀리부뜨(team reboott)는 국내 조선소와 함께 스캔 도면에서 태그별 설계 값을 찾는 PoC를 했고, 같은 엔진으로 선적서류 추출과 계약 문서 개정본 비교를 고객사 사내 서버에서 시범 운영하고 있습니다.
요약
도면 AI는 글자를 읽는 OCR만으로는 부족합니다.
팀리부뜨는 도면 PDF를 쪽 단위로 나눠 글, 표, 도면으로 분류하고, 쪽 이미지를 직접 검색해 값이 있을 만한 쪽을 고른 뒤, 이미지와 판독 텍스트를 함께 보고 값을 뽑습니다.
모든 값에는 근거 파일, 쪽, 신뢰도가 붙고, 신뢰도가 낮은 값만 담당자에게 넘어갑니다.
스캔 도면 2종 134쪽 PoC에서 20개 값을 모두 맞혔고 근거 쪽도 전부 확인했습니다.
도면 AI는 도면과 사양서에서 필요한 설계 값을 찾아 구조화된 데이터로 바꾸는 AI입니다. 도면에서 값을 찾는 일이 OCR로 끝나지 않는 이유는 글자를 읽는 것보다 어느 쪽의 어느 값을 읽을지 고르는 것이 더 어렵기 때문입니다.
OCR은 페이지의 글자를 텍스트로 바꿔 줍니다. 그런데 도면에는 같은 글자가 여러 곳에 찍혀 있습니다. 전원 사양 AC440V 3PH 60Hz는 공통 사양서에도, 장비별 결선도에도, 제어 회로도에도 나옵니다.
태그가 도면에 직접 적혀 있지 않은 경우도 많습니다. 태그 번호 대신 "No.1 스타터", "서보 펌프" 같은 장비 이름으로 그려져 있어서, 태그 설명의 뜻을 보고 찾아가야 합니다.
값의 모양도 제각각입니다. 표에서 바로 읽는 값이 있고, 도면 주기 한 줄을 전압, 상 수, 주파수 세 개로 나눠야 하는 값이 있고, 회로도의 심볼 개수를 세야 나오는 수량도 있습니다.
그래서 도면 데이터 추출은 세 가지 일을 함께 해야 합니다. 맞는 쪽을 찾고, 그 쪽에서 맞는 값을 읽고, 그 값이 이 장비의 값인지 확인하는 일입니다.
팀리부뜨의 도면 AI는 쪽 분류, 쪽 검색, 판독, 검토 분기의 네 단계로 값을 찾습니다.

1. 쪽 분류
도면 묶음을 쪽 단위로 나누고 글, 표, 도면으로 분류합니다. 쪽마다 제목과 본문을 마크다운으로 판독해 두는데, 잔글씨는 쪽을 여러 조각으로 확대해 다시 읽습니다.
2. 쪽 이미지 검색
"서보 펌프 스타터의 정격 전압"처럼 태그와 속성을 문장으로 바꿔, 쪽 이미지에서 직접 후보 10쪽을 고릅니다. 글자를 먼저 뽑아 검색하는 방식보다 도면 쪽을 훨씬 잘 찾습니다. PoC에서 판독 텍스트 키워드 검색은 정답 쪽을 상위 10개 안에 35%만 넣었고, 쪽 이미지 검색은 100% 넣었습니다.
3. 이미지와 판독 텍스트를 함께 보고 추출
후보 쪽마다 이미지와 판독 텍스트를 같이 보여주고, 값과 근거 문장을 뽑게 합니다. 이미지만 보면 잔글씨를 잘못 읽고(6.1A를 6.2A로), 텍스트만 보면 표의 칸 관계를 놓칩니다. 쪽 번호는 모델이 쓰지 않고 코드가 정해서, 근거 쪽이 지어지지 않습니다.
4. 신뢰도로 검토 분기
값마다 신뢰도를 매겨 기준을 넘는 값은 엑셀이나 ERP 입력 양식으로 바로 보내고, 기준에 못 미치는 값만 담당자 화면에 근거 쪽과 함께 띄웁니다. 담당자는 1,500쪽을 다 보지 않고, 표시된 몇 쪽만 확인합니다.
도면 한 장에서는 표제란, 투상도별 치수와 공차, 부품표, 주기와 특기사항, 개정 이력이 각각 데이터로 나옵니다. 팀리부뜨의 CAD 에이전트는 도면을 올리면 먼저 이 영역들을 찾아 상자로 표시하고, 영역마다 값을 뽑습니다.

뽑은 값은 도면 위 위치와 함께 저장됩니다. 값을 누르면 도면에서 그 값이 나온 영역이 강조되기 때문에, 담당자는 원본과 바로 대조할 수 있습니다.
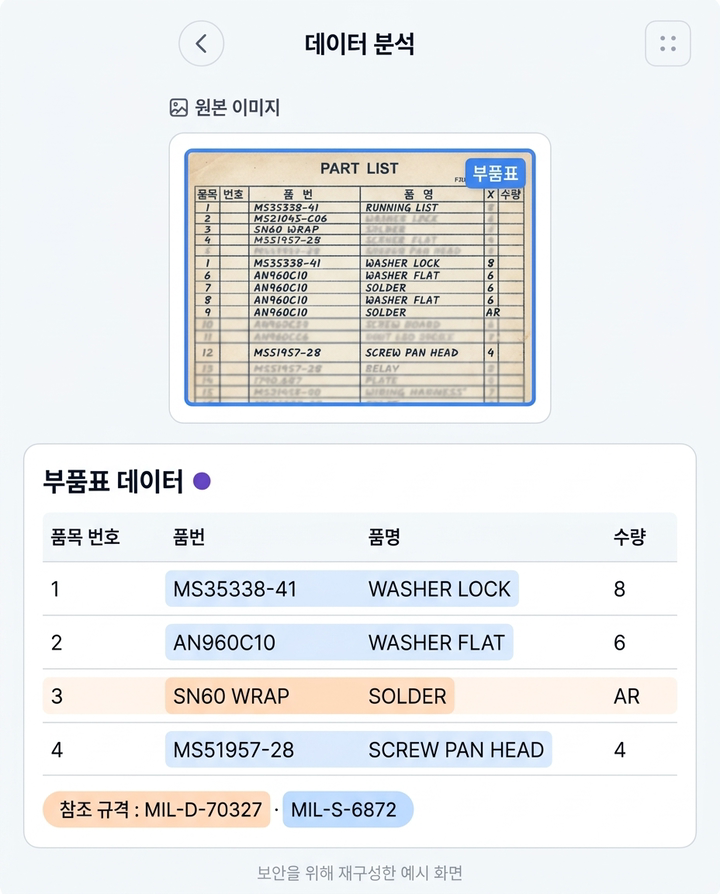
| 도면 속 정보 | 나오는 데이터 | 이어지는 업무 |
|---|---|---|
| 부품표 | 품목 번호, 품번, 품명, 수량 | BOM 등록, 자재 수량 산출 |
| 투상도 | 치수 기준값, 공차, 기하공차 | 성적서 초안, 검사 항목 정리 |
| 주기와 특기사항 | 일반 주기, 마킹 사양, 외부 참조 규격 | 사양 검토, 규격 누락 확인 |
| 표제란과 개정 이력 | 도면 번호, 개정 기호, 개정 일자 | 도면 목록 관리, 개정 이력 대조 |
병합 셀이 있는 표는 칸 관계가 깨지지 않게 행과 열 정보를 살린 표 형식으로 바꾸고, 수식과 단위(m³ 같은)는 따로 떼어 둡니다. 사내 AI 검색에 넣었을 때 "이 표의 2행 3열 값"을 그대로 물을 수 있게 하려는 것입니다.
값이 맞아도 다른 장비의 쪽에서 가져온 값이면 근거로 쓸 수 없기 때문입니다. 도면 AI를 평가할 때 값 정답률만 보면 실제 성능을 잘못 읽습니다.
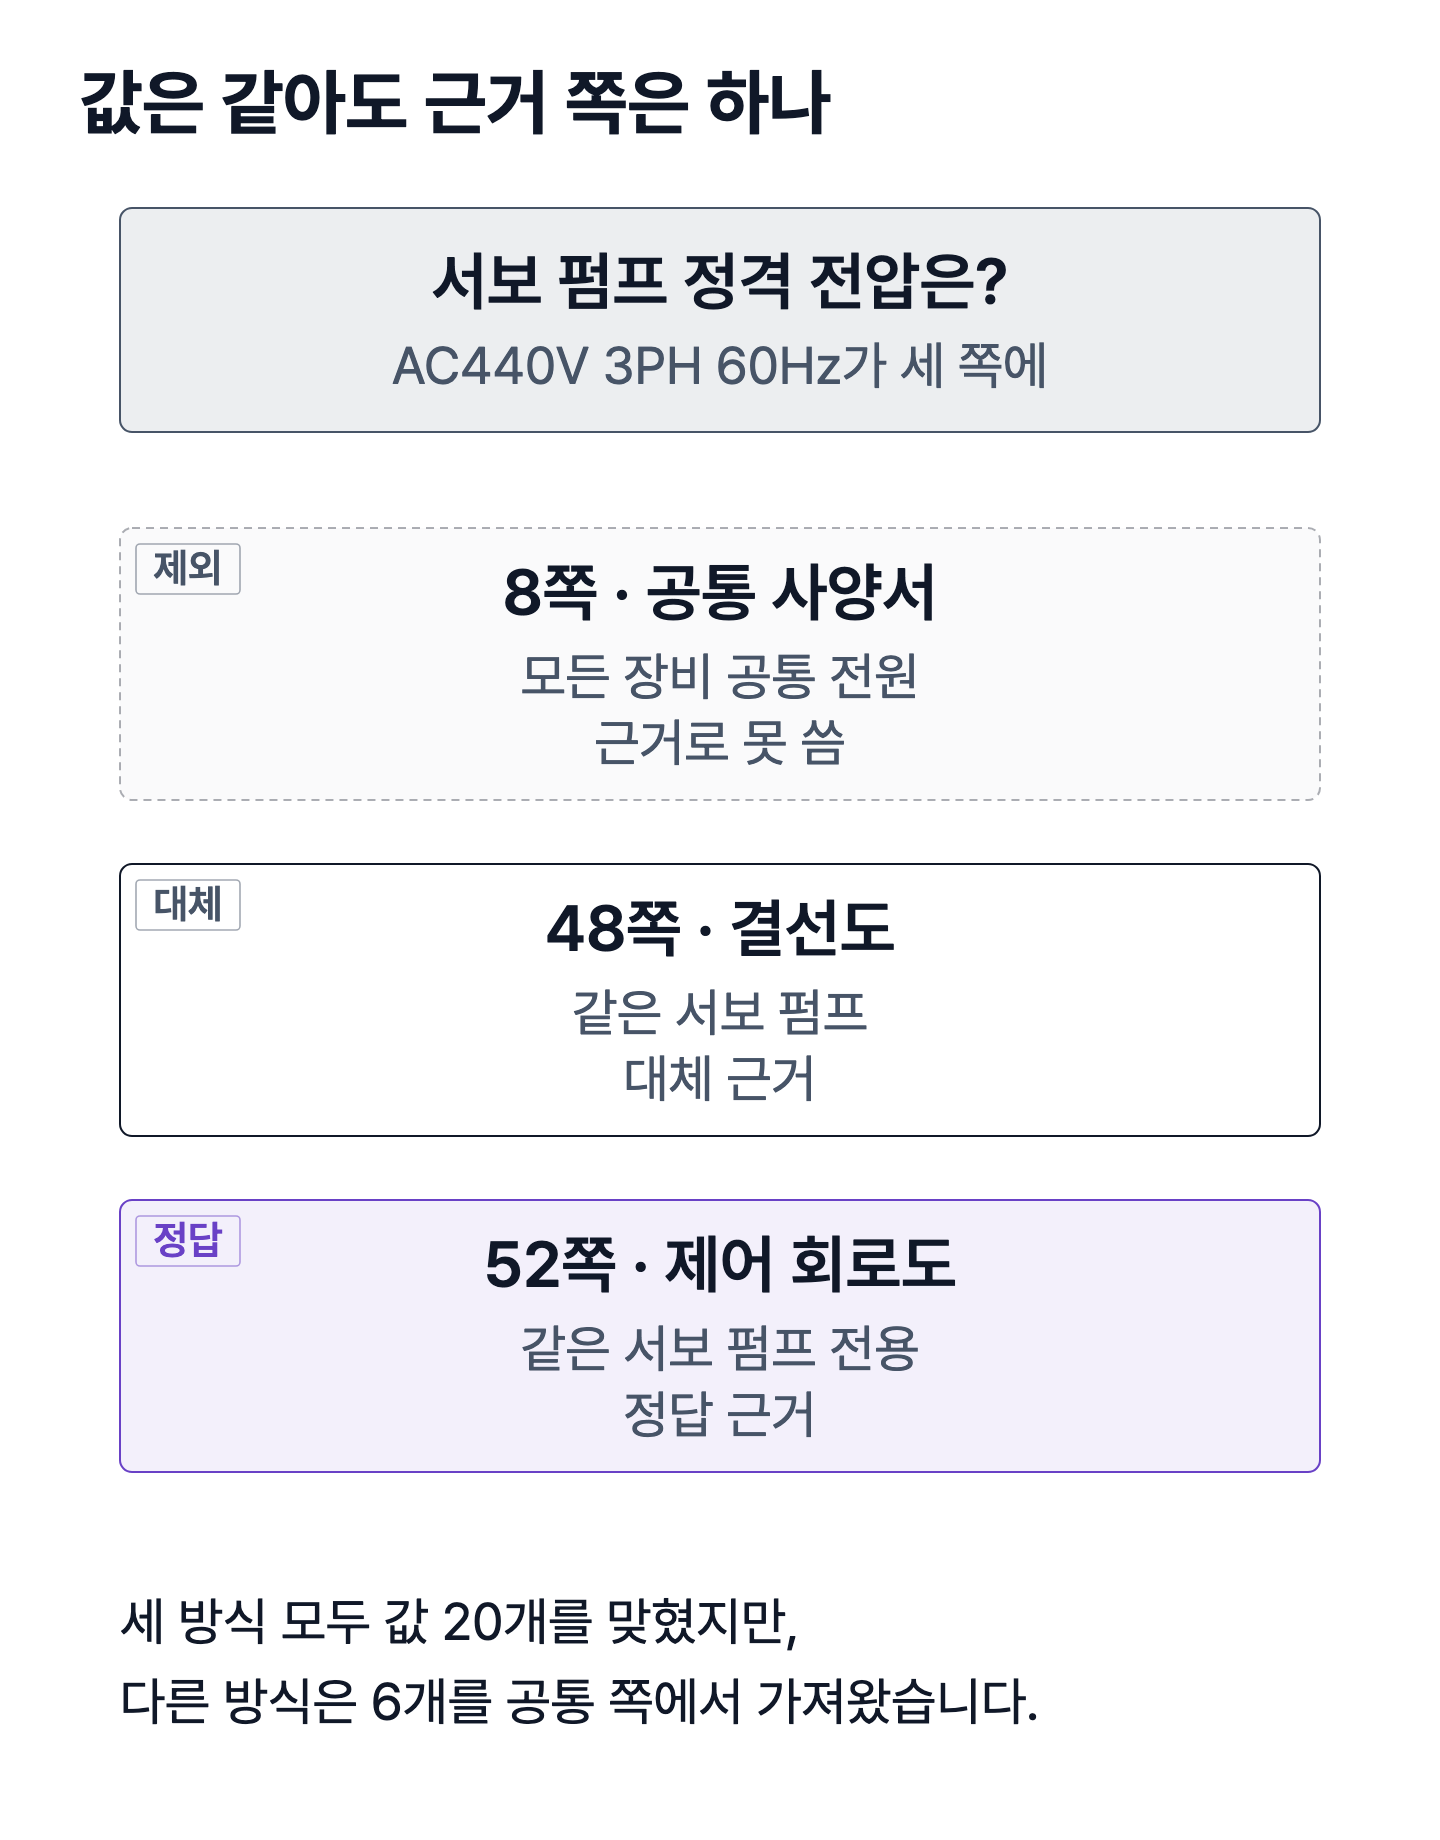
PoC에서 서로 다른 세 방식이 모두 20개 값을 맞혔습니다. 그런데 근거 쪽을 하나씩 확인하자 차이가 났습니다. 다른 방식은 20개 중 6개를 공통 사양서처럼 장비가 특정되지 않는 쪽에서 가져왔고, 팀리부뜨가 채택한 방식은 20개 모두 그 장비의 쪽을 근거로 댔습니다.
그래서 추출 규칙에 업무 기준을 함께 넣습니다. "값이 여러 쪽에 있으면 장비 전용 쪽을 인용한다", "유닛 태그에는 하위 장비 값을 넣지 않는다", "무게는 빈 상태 무게를 쓴다" 같은 규칙입니다. 이런 규칙은 설계팀의 머릿속에 있던 판단이라, 처음 몇 주는 담당자와 정답 표를 같이 맞추며 정리합니다.
문서 묶음이 커지면 어려움도 커집니다. 수십 개 PDF, 천 쪽이 넘는 패키지에서는 비슷한 회로도가 연달아 나오고, 태그만으로는 어느 문서를 봐야 할지 알 수 없는 경우가 생깁니다. 이때는 태그와 문서를 잇는 사내 메타데이터를 먼저 연결해, 검색 범위를 해당 문서 안으로 좁히는 것이 정확도를 가장 크게 올립니다.
도입할 수 있습니다. 팀리부뜨의 도면 AI는 고객사 GPU 서버에 그대로 설치합니다. 도면이 회사 밖으로 나가지 않습니다.
모델은 공개된 오픈소스 VLM을 문서 업무에 맞게 학습해 쓰고, vLLM으로 서빙합니다. 고객 서버의 GPU 사양에 맞춰 모델 크기를 고르고, 같은 정답 표로 여러 모델 조합을 비교해 정확도와 처리 속도의 균형점을 찾습니다. 조선소 PoC에서는 판독 모델 4종과 추출 모델 4종의 16개 조합을 같은 기준으로 비교했습니다.
사내망 인증, 실행 기록, 질문과 답변 저장 범위 같은 운영 조건도 회사 보안 정책에 맞춰 정합니다. 사내 서버 AI 구성과 보안 검토 항목은 온프레미스 AI 보안 글에서 자세히 다뤘습니다.
도면 AI로 할 수 있는 일은 크게 읽기, 비교하기, 업무 양식에 채우기 세 가지입니다. 아래 표의 단계는 지금 팀리부뜨가 어디까지 해 봤는지를 그대로 적은 것입니다.
| 할 수 있는 일 | 들어가는 자료 | 나오는 결과 | 단계 |
|---|---|---|---|
| 도면 영역 인식과 값 추출 | 도면 이미지, PDF | 표제란, 치수와 공차, 부품표, 주기 | 제품 기능 |
| 태그별 설계 값 찾기 | 스캔 도면, 사양서 묶음 | 값, 근거 파일, 쪽, 신뢰도 | 조선소 PoC |
| 개정본 차이 비교 | 같은 문서의 두 판 | 추가, 삭제, 이동, 문구 변경 표시 | 조선소 시범 운영, 무역상사 PoC |
| 유사 도면 찾기 | 도면 한 장 | 비슷한 과거 도면 목록 | 제품 기능 |
| 도면으로 BOM, 성적서 초안 | 승인도, 부품표 | BOM 엑셀, 성적서 양식 | 맞춤 구축 |
| 사양서로 Item List, 견적 기초 | 고객 Spec, Data Sheet | 필요 항목, 숨은 요구 경고 | 맞춤 구축 |
| 도면과 POS로 견적 초안 | POS, 도면, ERP 단가표 | 자재 종류, 규격, 수량, 견적 초안 | 맞춤 구축 |
| 사내 문서 검색에 도면 넣기 | 판독한 도면 | 질문에 값과 근거 쪽 이미지로 답변 | 맞춤 구축 |
태그별 설계 값 채우기
태그와 속성 목록을 엑셀로 넣으면, 도면 묶음에서 값을 찾아 값, 근거 파일, 쪽, 신뢰도를 한 줄씩 채운 엑셀을 돌려줍니다. 담당자는 신뢰도가 낮은 줄만 근거 쪽을 열어 확인합니다.
리비전 스무 번째에도 바뀐 곳만
승인도는 고객 코멘트를 받으며 수십 번 개정됩니다. 이전 판과 새 판을 조항, 표, 도면 영역 단위로 맞춰 놓고 바뀐 곳만 표시하면, 1,000쪽이 넘는 개정본을 처음부터 다시 읽지 않아도 됩니다.
승인도에서 BOM과 성적서 초안까지
부품표를 BOM 양식으로 옮기고, 치수와 공차 중 성적서에 들어갈 항목만 골라 엑셀 양식에 채웁니다. 400개 항목의 BOM을 손으로 치던 일이 초안 검토로 바뀝니다.
천 장 Spec에서 필요한 열다섯 개만
고객 사양서와 Data Sheet 수백 장에서 재질, 설계 조건, 도장 사양처럼 견적에 필요한 항목만 뽑고, General Spec에 숨어 있는 금지 조건을 경고합니다. 결과는 쓰고 계신 Item List 양식 그대로 나옵니다. 사양서 검토는 스펙 검토 자동화 글에서도 다뤘습니다.
도면과 POS로 견적 초안 만들기
조선소에서 받은 POS와 도면에서 밸브 종류, 규격, 재질, 수량을 뽑고 ERP의 단가표와 연결해 견적 초안을 만듭니다. 기자재 회사의 견적 담당자가 하루를 쓰던 수량 산출을 먼저 끝내 둡니다.
선적서류도 같은 엔진으로
도면을 읽는 엔진은 인보이스, 패킹리스트, B/L 같은 선적서류도 같은 방식으로 읽습니다. 기자재 입고 서류의 P/O 번호, 중량, 포장 수를 뽑아 구매 시스템에 맞춥니다. 자세한 방법은 선적서류 자동화 글에 정리했습니다.
읽을 수 있습니다. 팀리부뜨의 도면 AI는 텍스트 레이어가 없는 스캔 도면을 쪽 이미지로 직접 검색하고, 잔글씨는 쪽을 여러 조각으로 확대해 다시 판독합니다. 조선소 PoC의 도면 2종 134쪽도 본문 전체가 스캔 이미지였습니다.
모든 값에 근거 파일, 쪽, 신뢰도를 붙이고, 신뢰도가 기준에 못 미치는 값만 담당자에게 넘깁니다. 쪽 번호는 모델이 아니라 코드가 정하기 때문에 근거 쪽을 지어낼 수 없고, 담당자는 표시된 쪽만 열어 바로 확인할 수 있습니다.
도면 OCR은 쪽의 글자를 텍스트로 바꾸는 데서 끝납니다. 도면 AI는 필요한 값이 있는 쪽을 찾고, 같은 값이 여러 쪽에 있으면 그 장비의 쪽을 고르고, 표의 칸 관계와 도면 주기를 해석해 태그별 속성 값으로 정리합니다.
쓸 수 있습니다. 고객사 GPU 서버에 오픈소스 VLM을 설치해 vLLM으로 서빙하므로 도면이 회사 밖으로 나가지 않습니다. 모델 크기는 고객 서버 사양에 맞춰 고릅니다.
도면 묶음 하나와, 거기서 찾아야 하는 값 20~30개의 정답 표로 시작하는 것을 권합니다. 정답 표가 있으면 첫 2주 안에 어느 값이 바로 되고 어느 값에 업무 규칙이 필요한지 나눠서 보여드릴 수 있습니다.
지금 손으로 옮기고 계신 도면과 사양서, 채워야 하는 양식을 알려주시면 팀리부뜨의 도면 AI 구축 전문가가 처리 방식과 검증 방법을 함께 정리해드립니다.
업종별 적용 방법은 조선기자재 견적 자동화 글, 방산 기술자료 디지털화 글, 건축 도면 AI 글에서 따로 정리했습니다.
상담문의 시 "도면 AI 글을 보고 문의했다"고 남겨주시면 보다 원활한 상담이 가능합니다.